opencode-deveco
把 DevEco Code 的模型能力 —— GLM-5.3 / GLM-5.1 / 视觉模型 —— 无侵入地接进 opencode、Claude Code 以及任何 OpenAI 兼容客户端。 一条本地代理,一个端口,不改 opencode 一行源码。
git clone https://github.com/wenyinos/opencode-deveco && cd opencode-deveco
npm install && npm run build
npm start                     # 守护进程 + 代理,127.0.0.1:17128
curl http://127.0.0.1:17128/v2/login   # 浏览器登录一次
为什么是「代理」而不是插件
opencode 已发布的二进制不会加载外部插件的 auth hook,插件写得再完整也没人调用。 所以这个项目没走插件路线,而是一条跑在本机的 HTTP 代理:opencode 把它当作普通 OpenAI 端点,代理注入 DevEco 凭证后转发到华为。对外完全像一个标准模型服务 —— Claude Code 也能通过同一端口以 Anthropic 协议接入。
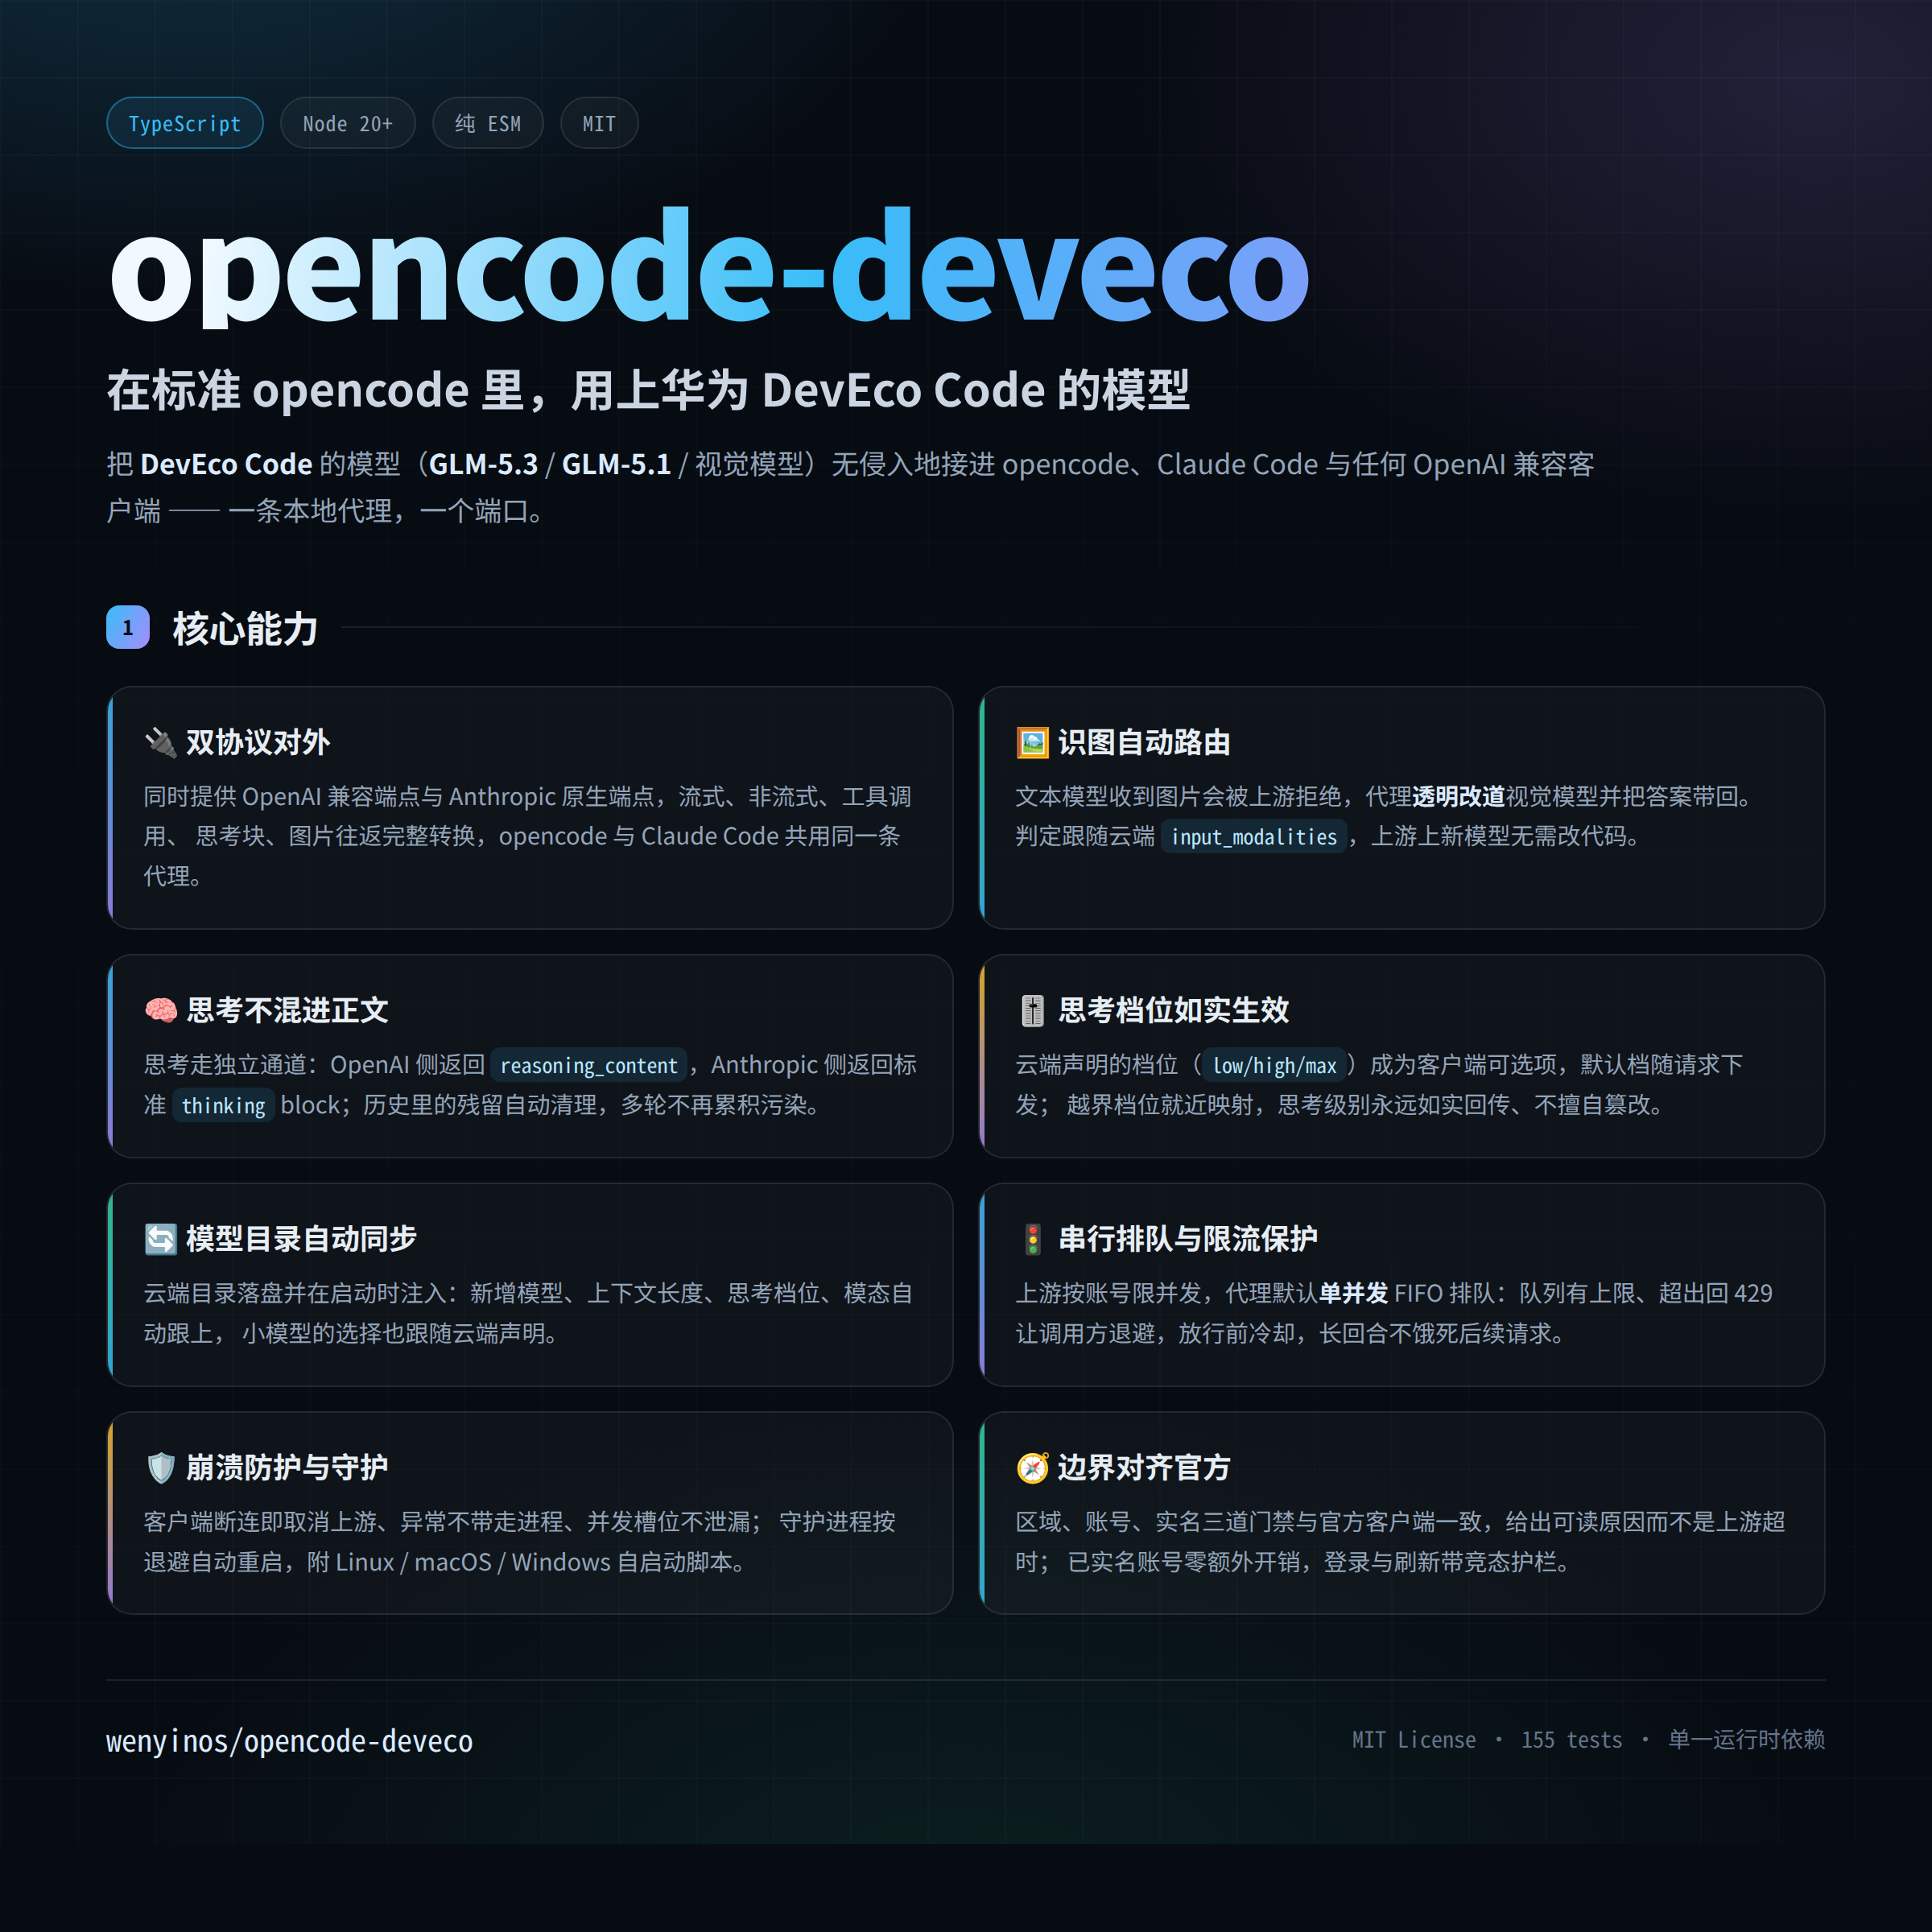
核心能力
🔌 双协议对外
同时提供 OpenAI 兼容端点 /v2/chat/completions 与 Anthropic 原生端点
/anthropic/v1/messages,流式与非流式都支持,工具调用、思考块、图片往返完整转换。
opencode 与 Claude Code 可以共用同一条代理。
🖼️ 识图自动路由
文本模型收到图片会被上游拒绝,代理会透明改道到视觉模型(Qwen3-VL)并把答案原样带回;
下一轮无图时自动切回。哪些模型算"文本-only"跟随云端 input_modalities,
上游新增模型无需改代码。
🧠 思考不再混进正文
DevEco 的 GLM 会把"自言自语"写进正文并以 </think> 收尾。
代理请求上游把它放到独立通道:OpenAI 侧是 reasoning_content,
Anthropic 侧是标准 thinking block;历史里的残留也会被清理,多轮不再累积污染。
🎚️ 思考档位如实生效
云端为每个模型声明的档位(GLM-5.3 为 low/high/max)成为客户端可选项,
默认档随请求下发。越界档位会就近映射 —— 实测 medium 原本静默落到最重档,
现在正确落在 high。该关思考时不擅自关,级别永远如实回传。
🔄 模型目录自动同步
云端模型目录会落盘并在启动时注入客户端:新增模型自动出现在选择器里,
带上上下文长度、思考档位与模态。与手写配置合并(你的字段优先),
small_model 也跟随云端声明。
🚦 串行排队与限流保护
DevEco 按账号限制并发,代理默认单并发且 FIFO 排队:排队入场前冷却、 队列有上限(超出直接 429 让调用方退避),元数据接口不占用生成槽位, 长回合不会把后面的请求饿死。
🛡️ 崩溃防护与守护
客户端断连立即取消上游、并发槽位不泄漏、写坏 socket 不致命、未捕获异常也不会带走进程;
npm start 可交给守护进程,退出后按退避自动重启。
附 systemd / launchd / Windows 自启动脚本。
🧭 边界行为对齐官方
区域、账号区域、实名状态三道门禁与官方客户端一致:不在服务区时给出明确原因 (而不是让用户对着上游超时猜),已实名账号零额外开销,登录/刷新也有竞态护栏, 登出后不会被在途请求"复活"。
快速开始
# 1. 获取代码并构建
git clone https://github.com/wenyinos/opencode-deveco
cd opencode-deveco && npm install && npm run build

# 2. 起服务:守护进程 + 代理,监听 127.0.0.1:17128
npm start

# 3. 登录一次(浏览器 OAuth,之后自动续期)
curl http://127.0.0.1:17128/v2/login

# 4. 用起来
opencode run "say hi" -m deveco/GLM-5.3
需要 Node 20+;模型列表、思考档位会随云端自动同步,无需手工维护。
项目海报
点击图片可在新标签页查看 2400×4340 原图